Nicht nur das Modell entscheidet
Wer Benchmarks für KI-Modelle liest, schaut meist zuerst auf den Modellnamen und den Endwert. Genau das ist in der Praxis zu kurz gedacht. Gerade bei anspruchsvollen Aufgaben kann nicht nur das Modell selbst, sondern auch das konkrete Inferenz-Setup den Ausschlag geben.
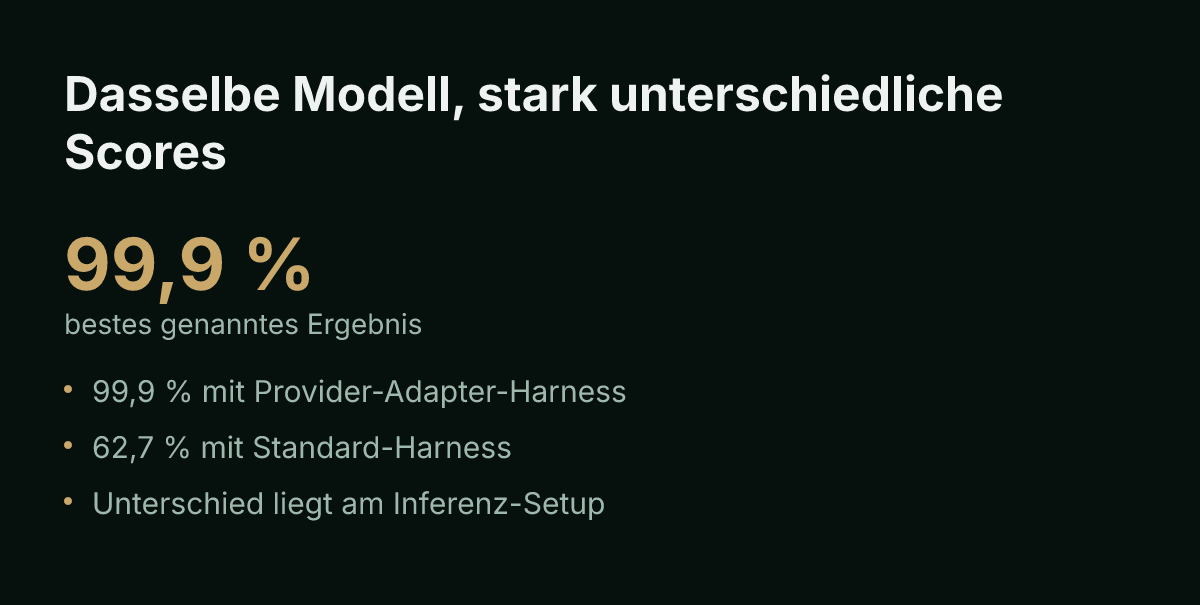
Ein aktuelles Beispiel dafür ist ARC-AGI-3. Aus den vorliegenden Quellen lässt sich ein Punkt klar ableiten: Dasselbe Modell kann auf demselben Benchmark je nach API- und Laufzeitkonfiguration massiv unterschiedliche Ergebnisse liefern. Genannt werden zwei Setups für dasselbe Modell: einmal 99,9 % mit einem speziellen Provider-Adapter-Harness, einmal 62,7 % mit dem Standard-Harness.
Für Unternehmen ist das keine akademische Fußnote. Es ist der Unterschied zwischen einem vermeintlichen Spitzenmodell und einem Modell, das im Alltag deutlich schwächer wirkt als erwartet.
Was hier konkret den Unterschied macht
Der beschriebene Provider-Adapter-Harness tut laut Quelle zwei Dinge:
- er erhält einen undurchsichtigen Reasoning-Zustand zwischen Anfragen
- er nutzt Komprimierung bei längeren Gesprächen
Beides zusammen erlaubt dem Modell, frühere Arbeit weiterzuverwenden, statt bei jedem Schritt praktisch wieder von vorne anzufangen.
Das ist operativ hoch relevant. Viele Benchmarks bestehen nicht aus einer einzigen, isolierten Eingabe. Sie enthalten Folgen von Zwischenschritten, Rückfragen, Korrekturen oder längeren Kontexthistorien. Wenn ein Setup den internen Arbeitsstand des Modells zwischen Requests besser erhält, steigt die Chance, dass es konsistent weiterarbeitet. Wenn zusätzlich längere Verläufe kompakt gehalten werden, bleibt mehr nutzbarer Kontext erhalten.
Anders gesagt: Wer nur „Modell A gegen Modell B“ vergleicht, vergleicht oft in Wahrheit ein Gesamtpaket aus Modell, API-Verhalten, Kontextverwaltung und Ausführungslogik.
Warum das für Pilotprojekte im Unternehmen wichtig ist
Im kaufmännischen Mittelstand sehe ich genau hier regelmäßig ein Risiko. Ein Team testet zwei Modelle mit einem einfachen Playground oder mit den Standard-Einstellungen eines Tools. Danach fällt eine Entscheidung für oder gegen einen Anbieter.
Das Problem: Solche Tests messen oft nicht das reale Potenzial, sondern nur das Potenzial unter einem zufälligen Setup.
Bei typischen kaufmännischen Anwendungsfällen ist das besonders heikel:
- Angebots- und Ausschreibungstexte mit vielen Iterationen
- Produktdatenpflege über längere Bearbeitungsketten
- Reklamations- und Servicefälle mit Vorgeschichte
- interne Wissensassistenten mit längeren Gesprächsverläufen
- Prüf- und Freigabeprozesse mit mehreren Entscheidungsschritten
In all diesen Fällen hängt die Ergebnisqualität nicht nur am Modell, sondern auch daran, wie Kontext erhalten, verdichtet und an den nächsten Verarbeitungsschritt übergeben wird.
Was „Reasoning-Erhalt“ praktisch bedeutet
Der Begriff klingt schnell nach Marketing. Praktisch geht es aber um eine einfache Frage: Muss das Modell bei jedem API-Aufruf die gesamte Denkarbeit erneut aufbauen, oder darf es intern auf vorherige Zwischenergebnisse aufsetzen?
Wenn ein System den relevanten Arbeitsstand zwischen Requests besser bewahrt, kann das mehrere Vorteile bringen:
- weniger Wiederholungen
- stabilere mehrstufige Bearbeitung
- geringere Fehlerquote bei langen Abläufen
- potenziell weniger Token-Verbrauch für erneute Herleitung
Die Kehrseite muss man aber ebenfalls benennen. Solche Setups machen Tests schwerer vergleichbar. Denn wenn ein Anbieter oder ein spezielles Harness internen Zustand besser konserviert als ein Standard-Setup, ist das Ergebnis zwar möglicherweise praxisnäher, aber nicht mehr direkt mit einem nackten Einzeldurchlauf vergleichbar.
Was Komprimierung im langen Kontext leistet
Der zweite Punkt aus der Quelle ist Komprimierung bei längeren Gesprächen. Das ist für Unternehmen oft noch greifbarer als der Reasoning-Erhalt.
In der Praxis wachsen Konversationen oder Verarbeitungsketten schnell an. Ohne sinnvolle Verdichtung treten drei Probleme auf:
- wichtige frühe Informationen fallen aus dem nutzbaren Kontext
- Kosten steigen durch immer längere Eingaben
- das Modell verliert Fokus auf die entscheidenden Fakten
Komprimierung bedeutet hier nicht einfach stumpfes Kürzen. Gute Komprimierung hält die arbeitsrelevanten Informationen verfügbar, ohne jeden Zwischenschritt erneut mitschleppen zu müssen.
Für kaufmännische Workflows ist das ein zentraler Hebel. Ein Assistent für Kundenservice, Einkauf oder Produktmanagement muss nicht jedes Wort der Historie behalten. Er muss die entscheidungsrelevanten Punkte zuverlässig mitführen.
Warum Benchmark-Werte ohne Setup-Dokumentation wenig belastbar sind
Wenn ein Benchmark-Ergebnis ohne Details zur Inferenz zustande kommt, sollten Entscheider vorsichtig sein. Ein Endwert allein beantwortet nicht die Fragen, die für eine Investitionsentscheidung wichtig sind:
- Wurde mit Standard-API oder Spezial-Harness getestet?
- Blieb interner Arbeitsstand zwischen Schritten erhalten?
- Wurde langer Kontext komprimiert oder roh übertragen?
- Wie viele Versuche waren erlaubt?
- Welche Kosten entstanden dafür?
Auch die Kostenseite darf man nicht ausblenden. In der Quelle werden für die beiden ARC-AGI-3-Setups unterschiedliche Kosten genannt: 99,9 % für 19K mit Provider-Adapter-Harness gegenüber 62,7 % für 26K mit Standard-Harness.
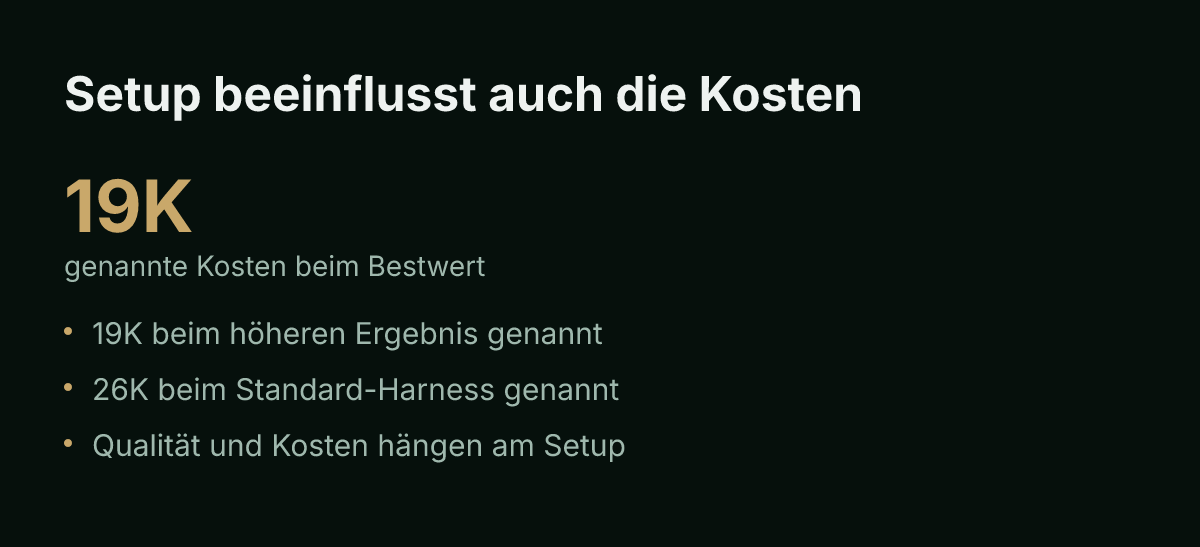
Das ist bemerkenswert, weil hier nicht nur die Qualität, sondern auch die Wirtschaftlichkeit vom Setup beeinflusst wird. Für Unternehmen ist genau das die eigentlich interessante Ebene: nicht der Bestwert in einer Folie, sondern Leistung pro Kosten- und Prozessrahmen.
Wie Sie Modelltests sauber aufsetzen
Wenn Sie Modelle für ein Pilotprojekt bewerten, sollten Sie nicht nur Prompts archivieren, sondern das gesamte Ausführungssetup.
Mindestens dokumentieren sollten Sie:
- Modellversion
- verwendete API oder Plattform
- maximale Kontextlänge im Test
- ob Gesprächshistorie vollständig, gekürzt oder komprimiert übergeben wurde
- ob Zwischenergebnisse zwischen Schritten erhalten blieben
- Anzahl der Bearbeitungsschritte pro Aufgabe
- Anzahl erlaubter Versuche
- Kosten pro Testlauf
- Bearbeitungszeit pro Fall
- Qualitätskriterien und Fehlerarten
Erst dann lassen sich Ergebnisse intern sauber vergleichen und später reproduzieren.
Ein praxistauglicher Bewertungsrahmen für den Mittelstand
Für den kaufmännischen Mittelstand muss ein Testverfahren nicht wissenschaftlich perfekt sein. Es muss belastbar genug für eine Investitionsentscheidung sein.
Ich empfehle einen einfachen Dreiklang:
1. Standard-Setup testen
Prüfen Sie zunächst, was mit Bordmitteln erreichbar ist. Das zeigt, wie gut ein Modell ohne Speziallogik performt und wie schnell Ihr Team produktiv werden kann.
2. Optimiertes Setup testen
Im zweiten Schritt testen Sie dasselbe Modell mit verbessertem Kontextmanagement, strukturierter Übergabe von Zwischenständen und sinnvoller Komprimierung.
3. Ergebnisdifferenz bewerten
Wenn sich die Resultate deutlich unterscheiden, haben Sie eine wichtige Erkenntnis: Nicht nur das Modell ist entscheidend, sondern die Architektur des Workflows.
Dann lautet die Managementfrage nicht mehr nur „Welches Modell kaufen wir?“, sondern „Welches Setup können wir stabil betreiben?“
Die unbequeme Wahrheit hinter vielen Modellvergleichen
Viele öffentliche Vergleiche wirken eindeutiger, als sie sind. Das Problem ist nicht, dass solche Ergebnisse wertlos wären. Das Problem ist, dass sie oft als reine Modelleigenschaft gelesen werden, obwohl sie in Wirklichkeit eine Kombination aus Modell und Ausführungsumgebung darstellen.
Für Entscheider heißt das: Benchmark-Werte sind ein Startpunkt, kein Beschaffungsargument.
Wenn ein Anbieter keine klare Aussage dazu machen kann,
- wie Kontext verwaltet wurde,
- wie mehrstufige Bearbeitung organisiert war,
- ob Reasoning-Zustände erhalten blieben,
- und welche Kosten je Ergebnis tatsächlich anfielen,
sollten Sie jede Vergleichsaussage mit Vorsicht behandeln.
Fazit
Die wichtigste Lehre aus dem ARC-AGI-3-Beispiel ist simpel:
Ein Benchmark misst nicht nur das Modell, sondern oft auch das Setup rundherum.
Gerade wenn zwei technische Einstellungen wie Reasoning-Erhalt zwischen Requests und Komprimierung längerer Verläufe ausreichen, um Ergebnisse drastisch zu verschieben, sind nackte Modellrankings als Entscheidungsgrundlage zu dünn.
Für den kaufmännischen Mittelstand ist deshalb nicht der lauteste Benchmark-Gewinner interessant, sondern das reproduzierbare Gesamtpaket aus Qualität, Kosten, Laufzeit und Betriebsfähigkeit.
Wer KI-Piloten seriös bewertet, dokumentiert nicht nur den Prompt und den Modellnamen. Er dokumentiert das Inferenz-Setup. Erst dann wird aus einem Demo-Eindruck eine belastbare Geschäftsentscheidung.