Nicht der Modellname entscheidet, sondern die Aufgabe
Wer KI-Agenten bewertet, landet schnell bei allgemeinen Modellvergleichen. Das ist verständlich, hilft in der Praxis aber nur begrenzt. Für Unternehmen zählt am Ende nicht, ob ein Modell in einem allgemeinen Ranking gut aussieht. Entscheidend ist, ob ein Agent die konkrete Aufgabe im eigenen Prozess zuverlässig erledigt.
Genau hier ist ein Benchmark wie EVMbench interessant. Auch ohne den Volltext der Ankündigung ist der Kern aus Titel und Kontext klar: Es geht um die Bewertung von KI-Agenten im Smart-Contract-Umfeld, also in einem Bereich, in dem Schwachstellen nicht nur ärgerlich, sondern geschäftskritisch sind. Ein solcher Benchmark ist deshalb relevant, weil er den Fokus weg von allgemeinen Modellversprechen und hin zu einer ganz praktischen Frage verschiebt: Erkennt, validiert und behebt ein Agent reale Fehler in einem klar abgegrenzten Fachkontext?
Für den kaufmännischen Mittelstand ist das kein Spezialthema aus der Blockchain-Ecke. Es ist ein Lehrstück dafür, wie Sie KI künftig einkaufen und bewerten sollten.
Warum Sicherheits-Benchmarks mehr aussagen als allgemeine Scores
Allgemeine Benchmarks messen oft isolierte Fähigkeiten. Das kann Sprachverständnis sein, mathematisches Lösen oder das Beantworten einzelner Fragen. Für operative Geschäftsprozesse reicht das nicht.
Sobald ein KI-Agent produktiv arbeiten soll, braucht er mehr als reine Textkompetenz. Er muss Informationen beschaffen, Werkzeuge korrekt einsetzen, Zwischenschritte sauber verbinden und am Ende ein belastbares Ergebnis liefern. Genau diesen Unterschied beschreibt auch die Analyse zu VAKRA sehr anschaulich.
Dort wird ein „tool-grounded, executable benchmark“ vorgestellt, der nicht nur Einzelkompetenzen testet, sondern „compositional reasoning across APIs and documents“ misst. Statt einfacher Frage-Antwort-Aufgaben geht es um vollständige Ausführungsspuren und darum, ob Agenten mehrstufige Workflows zuverlässig abschließen.
Das ist für Unternehmen der springende Punkt: In der Praxis scheitern KI-Agenten selten daran, dass sie gar nichts wissen. Sie scheitern daran, dass sie in einem mehrstufigen Ablauf an einer Stelle falsch abbiegen.
Was VAKRA für die Unternehmenspraxis sichtbar macht
Die VAKRA-Daten sind nicht aus dem Smart-Contract-Bereich, aber sie zeigen sehr gut, worauf es bei aufgabenspezifischen Benchmarks ankommt.
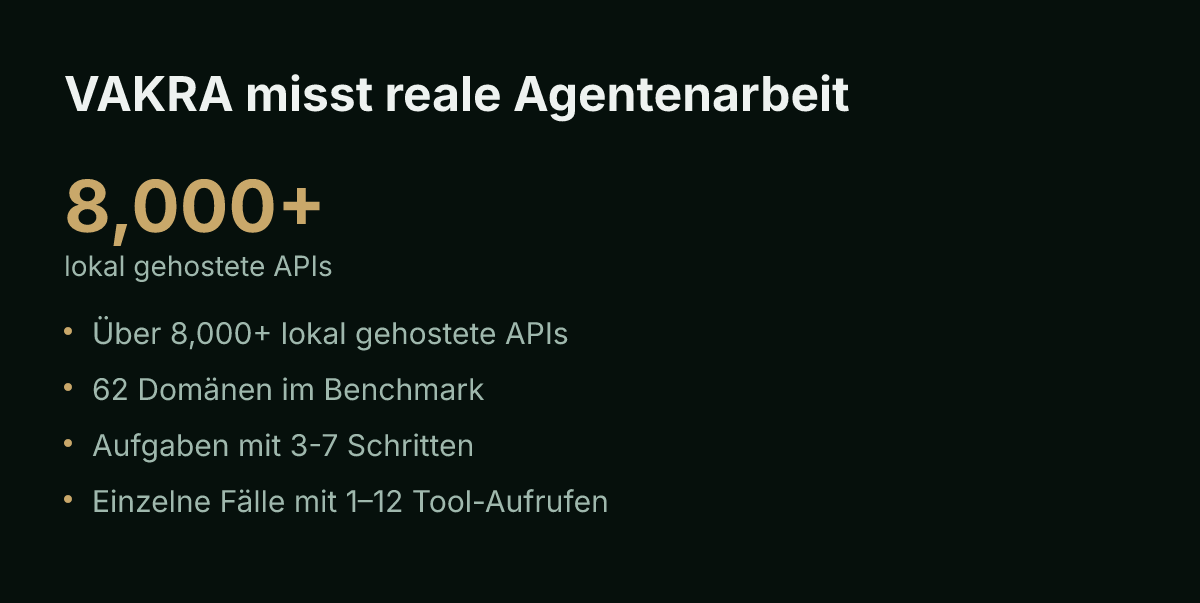
Der Benchmark stellt eine ausführbare Umgebung mit „over 8,000+ locally hosted APIs“ über „62 domains“ bereit. Aufgaben verlangen „3-7 step reasoning chains“, die strukturierte API-Nutzung und unstrukturierte Informationssuche kombinieren. In einzelnen Teilbereichen müssen Agenten sogar „1–12 tool calls“ verketten.
Das ist deshalb wichtig, weil viele Unternehmensprozesse genauso funktionieren:
- Daten aus einem System holen
- den relevanten Datensatz filtern
- eine Regel anwenden
- einen Sonderfall erkennen
- eine Entscheidung dokumentieren
- eine Folgeaktion im Zielsystem auslösen
Wenn ein Agent in Schritt 2 das falsche Tool wählt oder in Schritt 4 eine Ausnahme übersieht, ist das Ergebnis unbrauchbar. Ein guter allgemeiner Modellscore schützt davor nicht.
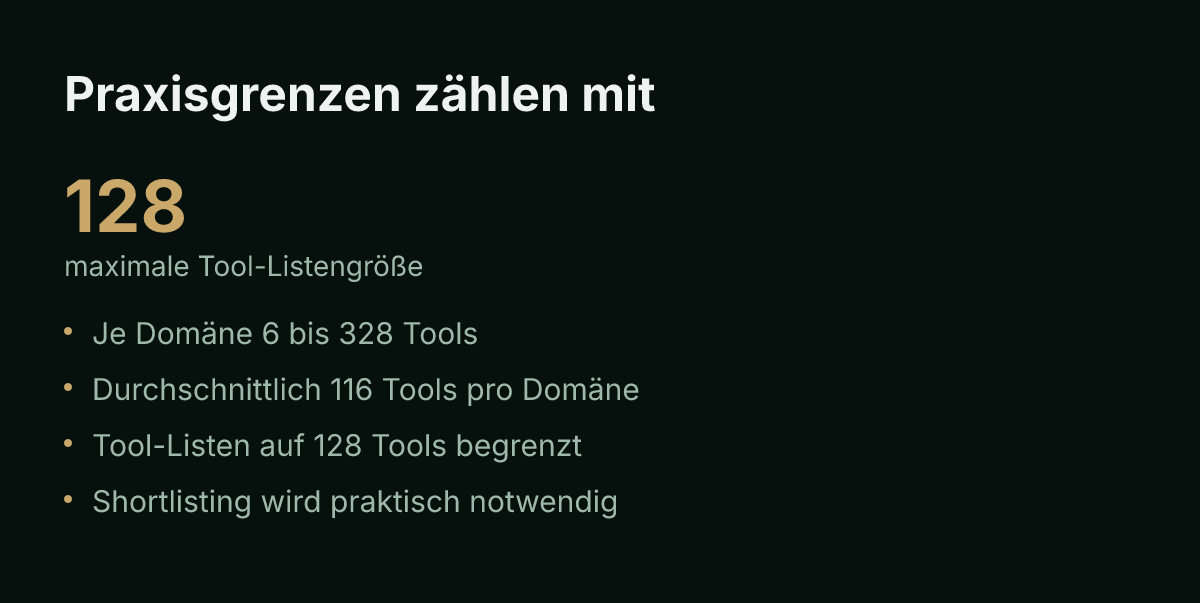
VAKRA zeigt außerdem eine zweite praktische Hürde: Nicht nur das Denken zählt, sondern auch die Werkzeuggrenzen. In einem Aufgabenbereich gibt es je Domäne zwischen „6“ und „328 tools“, im Durchschnitt „116 tools“. Gleichzeitig ist die Tool-Liste in einer verbreiteten API-Spezifikation auf „128 tools“ begrenzt. Das zwingt Agentenbauer zu einer Shortlisting-Logik.
Für Unternehmen ist das sehr lehrreich. Viele KI-Demos blenden solche Rahmenbedingungen aus. Im produktiven Einsatz sind genau diese Begrenzungen aber entscheidend. Ein Agent kann fachlich gut wirken und trotzdem operativ scheitern, weil Tool-Auswahl, Kontextfenster, Rechtekonzept oder Fehlerbehandlung nicht sauber gelöst sind.
Was EVMbench daraus für sensible Fachaufgaben ableitbar macht
Ein Sicherheits-Benchmark im Smart-Contract-Umfeld ist besonders streng. Dort reicht es nicht, ungefähr richtig zu liegen. Der Agent muss eine Schwachstelle erkennen, die Relevanz korrekt einordnen und idealerweise eine Änderung vorschlagen, die den Fehler behebt, ohne neue Probleme einzubauen.
Übertragen auf typische Unternehmensprozesse ist das sehr nah an Ihren realen Anforderungen. Auch dort genügt es nicht, dass ein System „ganz gute Vorschläge“ macht. Es muss in einem definierten Ablauf belastbar arbeiten.
Beispiele aus dem kaufmännischen Mittelstand:
- Erkennt der Agent in eingehenden Belegen die wirklich kritischen Abweichungen oder nur offensichtliche Standardfälle?
- Validiert er eine Vertragsklausel gegen interne Regeln oder formuliert er nur sprachlich plausible Kommentare?
- Schlägt er bei Stammdatenfehlern tatsächlich eine saubere Korrektur vor oder produziert er neue Inkonsistenzen?
- Kann er in Reklamationen die richtige Ursache herleiten und die passende Folgeaktion im ERP oder Ticketsystem auslösen?
Die eigentliche Lehre aus EVMbench ist deshalb nicht „Sicherheits-Benchmark ist wichtig“. Die wichtigere Lehre ist: Der Wert eines KI-Agenten zeigt sich an realen Fehlermustern in einer konkreten Aufgabe.
Was Sie bei KI-Beschaffung anders machen sollten
Wenn Sie KI-Agenten bewerten oder einkaufen, sollten Sie deutlich weniger nach allgemeinen Modellnamen fragen und deutlich mehr nach belastbaren Tests im Zielprozess.
Sinnvolle Fragen an Anbieter oder interne Projektteams sind zum Beispiel:
1. Welche konkrete Aufgabe wurde mit einem reproduzierbaren Benchmark getestet?
Nicht „Dokumentenverarbeitung“ allgemein, sondern zum Beispiel: Belegeingang mit Dublettenprüfung, Rechnungsvalidierung gegen Bestellbezug oder automatische Vorqualifizierung von Servicefällen.
2. Woran wurde Erfolg gemessen?
Bei sensiblen Prozessen reicht keine gefühlte Qualität. Sie brauchen klare Prüfkriterien:
- korrekt erkannt
- korrekt klassifiziert
- korrekt begründet
- korrekt im System dokumentiert
- korrekt an Folgeschritt übergeben
3. Wie sehen die Fehlermuster aus?
VAKRA ist gerade deshalb wertvoll, weil der Benchmark explizit auf „failure modes“ schaut. Genau das sollten Sie auch tun. Nicht nur Erfolgsquote, sondern Fehlerarten:
- falsches Tool gewählt
- richtiger Datensatz nicht gefunden
- Zwischenergebnis falsch interpretiert
- Ausnahmefall übersehen
- formal richtige, praktisch unbrauchbare Antwort erzeugt
4. Welche Systemgrenzen wurden im Test berücksichtigt?
Begrenzte Tool-Listen, Berechtigungen, unvollständige Daten, unterschiedliche Datenqualität, Zeitlimits, Kosten pro Lauf: All das gehört in einen realistischen Test.
5. Wie wurde abgesichert?
Gerade bei riskanten Aufgaben brauchen Sie Kontrollpunkte. Also Freigaben, Schwellenwerte, Stichproben und klare Regeln, wann ein Mensch übernehmen muss.
Ein pragmischer Weg für den Mittelstand
Sie brauchen keinen eigenen Forschungsbenchmark, um von diesem Denken zu profitieren. Ein pragmischer Ansatz reicht oft aus.
Nehmen Sie einen klar abgegrenzten Prozess mit wirtschaftlicher Relevanz. Sammeln Sie 50 bis 100 echte Fälle aus der Vergangenheit, inklusive Standardfällen, Grenzfällen und bekannten Fehlern. Definieren Sie dann das gewünschte Ergebnis je Fall und bewerten Sie einen KI-Agenten nicht nach der Qualität einzelner Formulierungen, sondern nach Prozessleistung.
Das kann ganz nüchtern in einer Testmatrix passieren:
- Fall korrekt erkannt: ja oder nein
- benötigte Datenquellen korrekt verwendet: ja oder nein
- Begründung nachvollziehbar: ja oder nein
- Folgeaktion korrekt: ja oder nein
- manuelle Nacharbeit nötig: ja oder nein
Damit erhalten Sie ein viel ehrlicheres Bild als mit jeder allgemeinen Modell-Demo.
Wo die Umsetzung hakt
So sinnvoll aufgabenspezifische Benchmarks sind, so klar sind auch die Hürden.
Erstens: Sie brauchen gute Testfälle. Viele Unternehmen haben zwar historische Vorgänge, aber keine sauber dokumentierten Soll-Ergebnisse.
Zweitens: Fachbereiche und IT müssen gemeinsam bewerten. Ein rein technischer Test reicht nicht, wenn der geschäftliche Fehler erst in der Buchhaltung, im Kundenservice oder im Vertrieb sichtbar wird.
Drittens: Benchmarks altern. Prozesse ändern sich, Regeln ändern sich, Datenquellen ändern sich. Ein einmal guter Test ist kein Dauerzertifikat.
Viertens: Ein Benchmark ersetzt keine Governance. Auch ein gut getesteter Agent braucht klare Verantwortlichkeiten, Freigaberegeln und Monitoring.
Fazit
EVMbench ist für Unternehmen vor allem deshalb relevant, weil es einen wichtigen Perspektivwechsel schärft: Die Qualität eines KI-Agenten zeigt sich nicht im allgemeinen Modellmarketing, sondern in der verlässlichen Leistung auf einer konkreten Fachaufgabe.
Die VAKRA-Analyse stützt dieses Denken sehr gut. Dort wird sichtbar, dass reale Agenten an mehrstufigen Abläufen, Werkzeugwahl und Ausführungsgrenzen scheitern können, obwohl sie auf dem Papier leistungsfähig wirken.
Für den kaufmännischen Mittelstand ist die Konsequenz klar: Beschaffen und bewerten Sie KI künftig stärker über aufgabenspezifische Benchmarks. Nicht „Welches Modell ist das beste?“, sondern „Löst der Agent meinen kritischen Prozess zuverlässig, nachvollziehbar und mit beherrschbarem Risiko?“
Wer diese Frage sauber testet, trifft in der Regel die besseren KI-Entscheidungen.